Claude 2026 能力全解析:它已经不只是聊天模型,而是一套 AI 工程平台
Claude 现在已经不只是一个“很会写作的聊天模型”。
它正在变成一套完整的 AI Coding、Agent、Tool Use、MCP、文档理解与企业自动化平台。对软件工程师来说,真正重要的变化不是模型回答得更像人,而是它开始能够进入代码库、操作工具、理解文档、拆解任务,并在较长的执行流程中持续工作。
本文会从模型定位、Claude Code、Agent、MCP、PDF/IDP、成本、隐私和企业落地几个角度,分析 Claude 在 2026 年适合做什么,以及开发者应该怎样选模型。
文中的能力评分属于工程选型参考,不是 Anthropic 官方 benchmark。
一、Claude 模型应该怎样分工?
目前 Claude 家族可以按照四种角色理解:
| 模型 | 最适合的工作 | 主要定位 |
|---|---|---|
| Fable 5 | 最复杂、最长时间的 Agent 与深度研究任务 | 能力上限 |
| Opus 5 | 架构设计、大型代码库、复杂 debugging、独立审查 | 高难工程 |
| Sonnet 5 | 日常开发、代码修改、文档、企业 Agent | 平衡型主力 |
| Haiku 4.5 | 分类、路由、简单抽取、大量低成本请求 | 快速执行层 |
真正合理的做法,不是所有任务都使用最贵的模型,而是像组织一个工程团队:
- Sonnet 负责大多数日常任务。
- Opus 处理难题并担任 senior reviewer。
- Haiku 处理大量简单工作。
- Fable 只留给能力要求最高、能够接受其数据保留条件的任务。
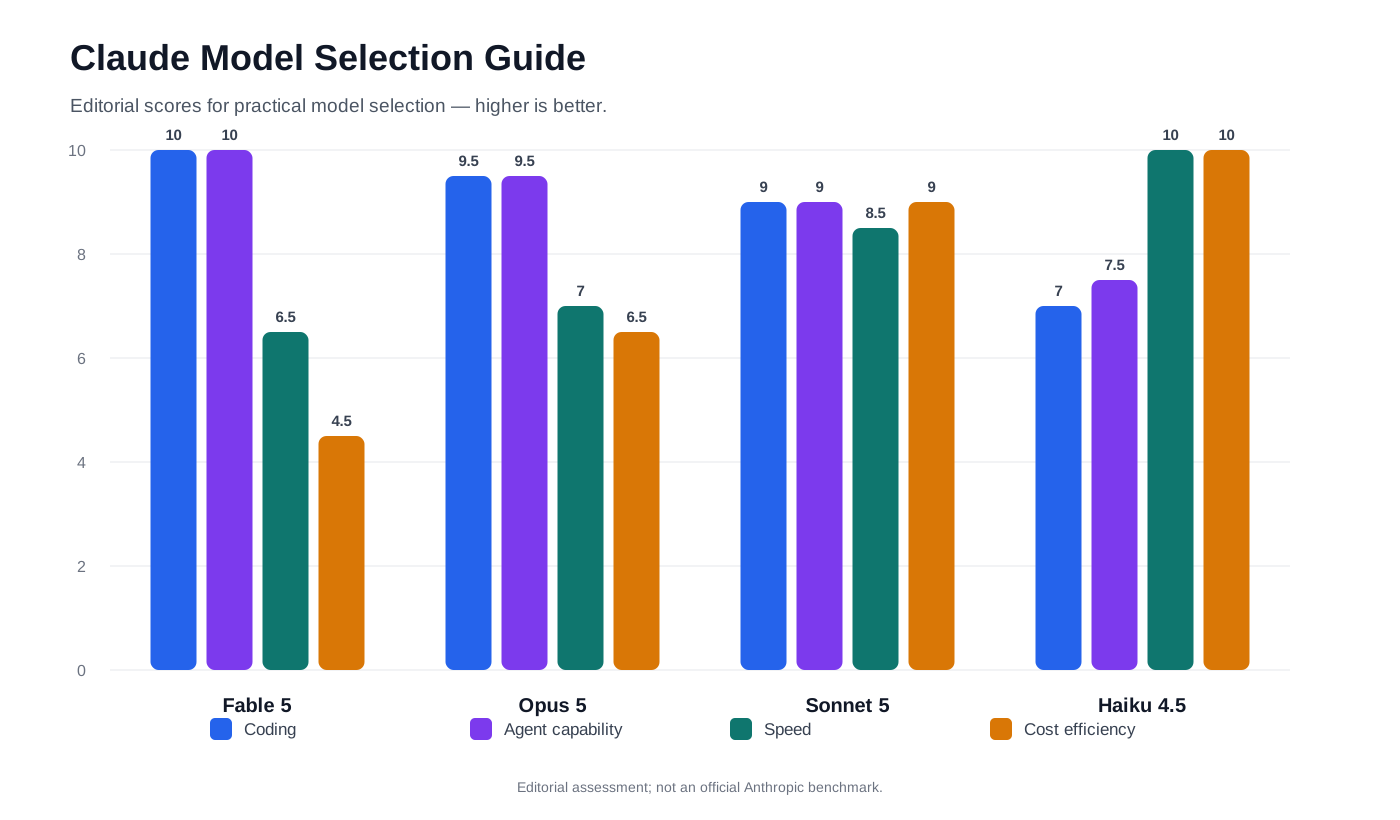
从图中可以看到:
- Fable 5 的 Coding 与 Agent 能力最高,但速度和成本效率较弱。
- Opus 5 适合困难工程与高质量审查。
- Sonnet 5 是整体最平衡的日常选择。
- Haiku 4.5 在速度和成本效率上最突出,但不适合承担最复杂的决策。
二、Claude 最强的能力:大型代码库开发
Claude Code 的价值,不只是生成一段函数或 SQL。
它可以直接进入一个 repository,阅读多个文件,理解项目结构,再完成一连串工程动作:
- 搜索和阅读代码。
- 修改多个相关文件。
- 执行 terminal command。
- 运行 lint、test 和 build。
- 分析错误日志。
- 处理 Git branch、commit 和 pull request。
- 根据项目规则持续工作。
- 调用 MCP 和外部工具。
这使 Claude Code 更像一个能进入工程现场工作的开发者,而不是只能在聊天窗口给你代码片段的助手。
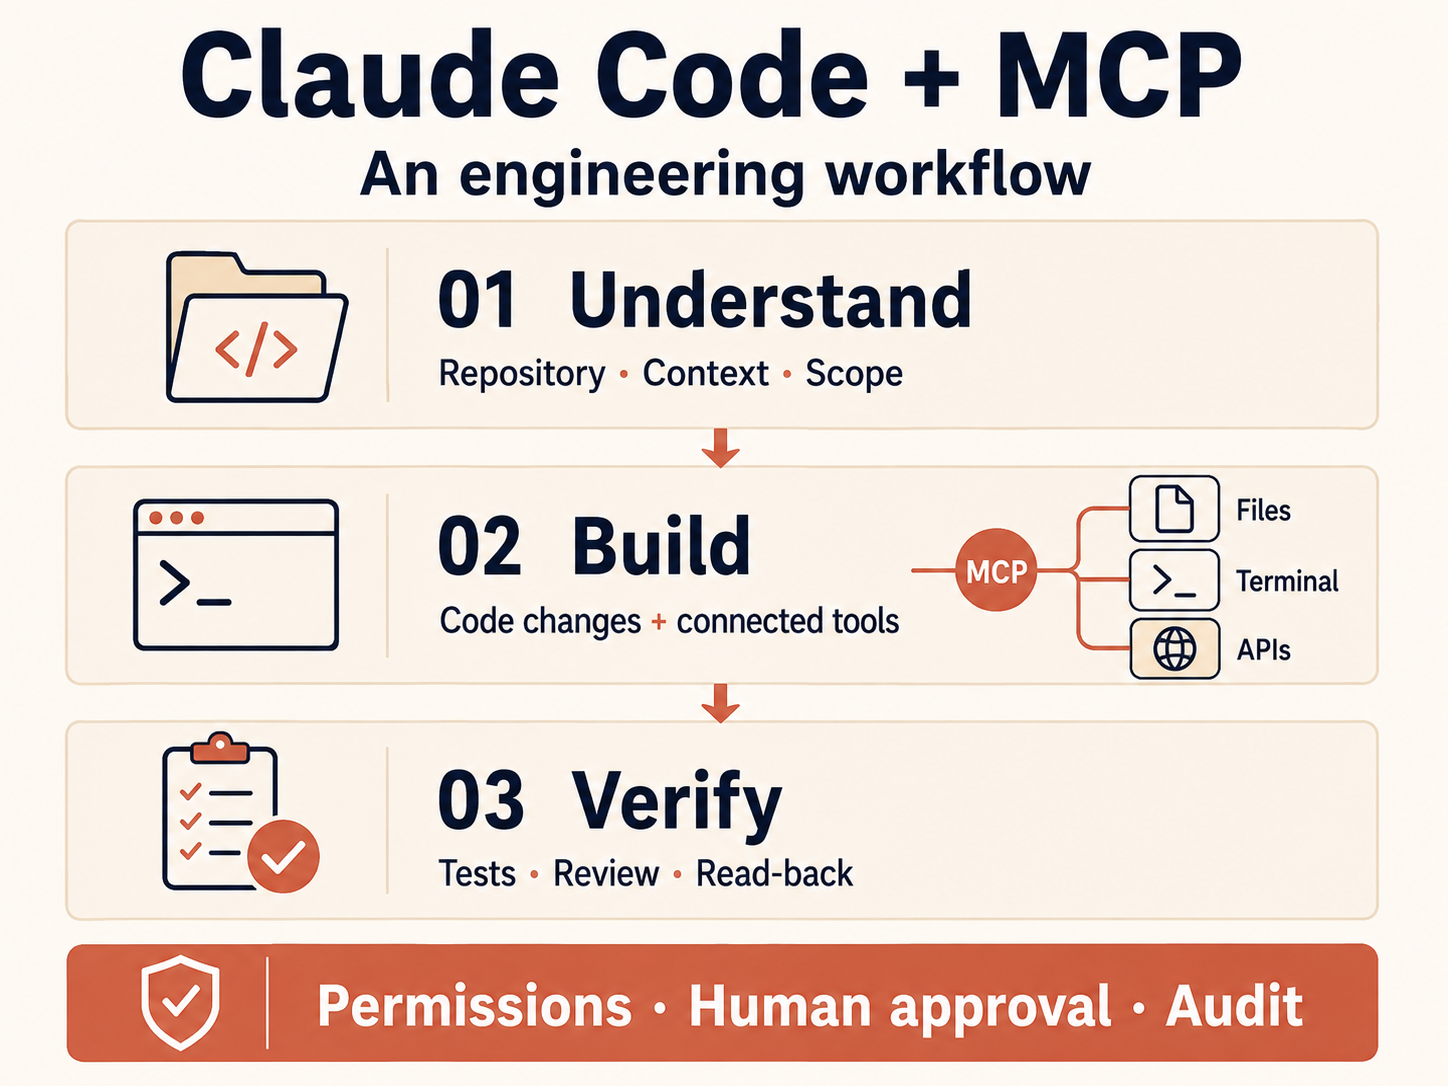
对于企业项目,Claude Code 特别适合以下工作:
1. 跨文件功能开发
例如一个 ERP 功能可能同时涉及:
- CFML 页面。
- JavaScript 交互。
- PostgreSQL 查询。
- API endpoint。
- Report 或 print form。
- 测试和文档。
传统聊天模型容易只修改用户提到的一个文件。Claude Code 更适合先理解依赖关系,再完成整个 change set。
2. 复杂 Debugging
真正困难的 bug 通常不是 syntax error,而是:
- 状态在多个组件之间不同步。
- 一个修改破坏另一个旧功能。
- SQL 返回正确数据,但业务定义错误。
- 缓存导致 UI 和数据库状态不同。
- 工具调用顺序错误。
Claude 的优势是能够读取较多上下文,并沿着调用链和数据流继续追查。
3. 代码审查与回归风险检查
Opus 级别模型特别适合担任第二个 reviewer:
- 检查修改是否扩大范围。
- 找出没有覆盖的 edge case。
- 比较 implementation 与 acceptance criteria。
- 检查权限、数据验证和审计问题。
- 确认测试是否真的证明功能正确。
不过,Claude 仍然可能“做太多”。因此开发任务最好明确限制:
Only modify files directly required for this issue.
Do not refactor unrelated code.
Preserve all existing behaviour.
Run regression tests before completion.
List every changed file and the reason.
Stop when the acceptance criteria pass.
三、Claude + MCP:从模型变成工程 Agent
Claude 的另一个核心能力是 Tool Use 和 MCP。
MCP 可以让模型连接:
- 文件系统。
- PostgreSQL 或内部 API。
- Jira。
- GitHub。
- Google Drive。
- Slack。
- 企业知识库。
- 浏览器和自动化工具。
这意味着 Claude 不再只能依靠 prompt 里的文字,而是可以在需要时主动取得资料、执行操作,并把结果带回推理过程。
但是,工具越多,不代表 Agent 越强。
如果一次暴露几十甚至几百个工具,模型会面对三个问题:
- Tool schema 占用大量 context。
- 相似工具之间容易选错。
- 企业权限和业务边界变得难以管理。
更合理的结构是:
User Request
    ↓
Skill Router
    ↓
Business Module
    ↓
Validated API / Report Function
    ↓
Permission Check
    ↓
Claude Explanation or Draft Action
    ↓
Human Approval
    ↓
Execution + Read-back + Audit
在 ERP 中尤其不能把所有 database table 直接开放给 Agent。否则模型可能生成技术上可执行、业务上却错误的查询。
例如“Top 10 Customers”看起来只是 group by customer,但真实业务可能还涉及:
- 哪些 transaction type 才算销售。
- 是否扣除 credit note。
- 使用 local currency 还是 forex。
- 按 invoice date 还是 posting date。
- 是否排除内部客户。
- 必须跟哪一个正式报表对账。
所以企业 AI Agent 的核心不是“让模型自由查数据库”,而是让它通过已验证的业务接口工作。
四、PDF、IDP 与结构化资料抽取
Claude 同时具备文字和视觉理解能力,因此很适合处理:
- Invoice。
- Purchase Order。
- Delivery Order。
- Bank statement。
- Contract。
- Report。
- 含表格、图表和图片的 PDF。
一个可靠的 IDP 流程不应该只是:
PDF → Model → JSON
而应该是:
PDF
  → Document classification
  → Claude vision extraction
  → Structured JSON schema
  → Field validation
  → Cross-field reconciliation
  → Human review when uncertain
  → ERP import
Structured Output 能减少以下问题:
- Invalid JSON。
- 字段缺失。
- 数据类型错误。
- 工具参数格式错误。
但它只能保证结构,不保证内容一定正确。
例如模型可能稳定返回:
{
  "subtotal": 1000,
  "tax": 90,
  "total": 1200
}
JSON 完全合法,但数字无法对账。因此企业 IDP 还必须检查:
subtotal + tax = total
以及:
- Currency 是否一致。
- Invoice number 是否重复。
- Supplier 是否存在。
- PO quantity 与 invoice quantity 是否合理。
- 多页数据是否属于同一份文件。
五、Claude 的弱点
1. Context 很大,不代表不会遗漏
长 context 只代表模型能够接收更多内容,不代表它一定会正确使用所有内容。
它仍然可能:
- 忽略中间段落。
- 混淆新旧 specification。
- 选错相似的 business rule。
- 依据错误资料作出非常合理的解释。
所以 repository、validated report、database result 和正式文档仍然必须是 source of truth。
2. Agent 可能扩大修改范围
Claude Code 有时会看到一个小问题,却顺便:
- 重构附近代码。
- 改变 architecture。
- 增加不必要的 abstraction。
- 调整未要求的 UI。
这也是为什么 AI Agent 经常“修好 A,却弄坏 B”。
解决方式不是只要求模型“小心一点”,而是建立:
- 明确 scope。
- 文件 allowlist。
- Regression test。
- Diff review。
- Independent reviewer。
- Acceptance gate。
- Rollback strategy。
3. 成本会被长上下文放大
当一个任务同时包含:
- 大型 repository。
- 大量 tool definitions。
- 很长的 terminal output。
- PDF 内容。
- 多轮 reasoning。
Token 成本会快速增长。
因此应先 retrieval,再只提供任务所需的:
- Relevant files。
- Schema。
- Business rule。
- Error log。
- Acceptance criteria。
六、隐私与企业数据
对于客户资料、ERP 数据、生产 source code、PDF 文件和数据库记录,模型能力不是唯一考虑因素。
还必须确认:
- 数据是否用于训练。
- Prompt 和 output 保留多久。
- 是否支持 Zero Data Retention。
- 是否有 enterprise agreement。
- 管理员能否控制 logging。
- 数据储存地区和 subprocessors。
针对敏感企业资料,最低要求应包括:
- 使用商业 API 或 Enterprise 配置。
- 默认关闭训练使用。
- 优先选择 Zero Data Retention endpoint。
- 对姓名、账号、地址和客户编号进行脱敏。
- 不把 credential 写进 prompt。
- 工具权限采用 least privilege。
- 所有写入动作保留 audit trail。
能力最强的模型,如果不符合数据政策,也不应该接触真实生产资料。
七、针对开发者的实际选型
日常开发:Sonnet 5
适合:
- JavaScript、TypeScript、CFML、SQL。
- Bug fixing。
- 中小型 feature。
- 测试与文档。
- 根据 Jira task 执行。
它应该是大部分开发工作的默认模型。
困难工程:Opus 5
适合:
- 大型 architecture。
- 多模块重构。
- 难以复现的 production bug。
- Performance root-cause analysis。
- Security 和 regression review。
- 审查其他 Agent 完成的代码。
大量简单任务:Haiku 4.5
适合:
- Document classification。
- Intent routing。
- 简单字段抽取。
- 标签生成。
- 批量摘要。
- Agent 的轻量子任务。
最高难度任务:Fable 5
适合:
- 超长执行 Agent。
- 深度研究。
- 最复杂的 reasoning 和 engineering workflow。
但必须先确认其数据保留条件是否符合项目的隐私要求。
八、Claude 在企业 AI 架构中的位置
比较合理的组合不是让一个模型包办所有事情,而是让不同系统负责不同职责:
ChatGPT
  = Management / Control Centre

Claude Code
  = Implementation Agent

Claude Opus
  = Architecture and Independent Reviewer

Claude Sonnet
  = Daily Engineering Agent

Claude Haiku
  = Router / Classifier / Cheap Subagent

Repository + Validated APIs + Database Reports
  = Source of Truth
模型负责理解、判断和生成;确定性系统负责:
- 权限。
- 状态。
- 重试。
- 数据合并。
- 业务计算。
- 验收。
- 审计。
这才是从 AI Demo 走向 Production AI 的关键。
最终结论
Claude 当前最强的地方,不只是文字质量,而是它已经形成一套完整的 AI 工程工作方式:
- 能理解大型代码库。
- 能操作 terminal 和工具。
- 能通过 MCP 连接企业系统。
- 能处理 PDF 和结构化抽取。
- 能运行较长的 Agent workflow。
- 能作为实现者,也能作为独立 reviewer。
但 Claude 仍然不是一个可以无监督控制 production 的“万能工程师”。
真正可靠的落地方式是:
Sonnet 做日常工作,Opus 解决困难工程问题,Haiku 处理大量简单任务;所有关键结果都必须经过工具验证、测试、权限控制、人工审批与结果回读。
模型是大脑,MCP 是手脚,repository 和数据库是现实,而测试与审批才是最后的安全网。