Qwen3.8-Max 对比 Gemini、GPT 与 Claude:能力、成本、数据隐私与 AI Agent 选型
资料更新日期:2026 年 8 月 5 日
模型排名、Preview 状态和 API 价格变化很快。本文采用当时可查到的官方文档与公开排行榜数据,并对尚未正式商业化的资料作出明确标记。
先讲结论
如果只追求最高能力,Claude Fable 5 是目前比较稳妥的选择。
如果关注价格与能力的平衡,Qwen3.8-Max 是最值得关注的挑战者,但它目前仍有 Preview、计费透明度和企业合规资料不足的问题。
如果主要处理 PDF、图片、录音、视频和复杂文件,Gemini 3.1 Pro 最实用。
如果要建设完整 AI Agent,包括 Tool Calling、MCP、Code Interpreter、Computer Use 和结构化输出,GPT-5.6 Sol 的平台组合最完整。
简单来说:
- Claude: 最强,但最贵。
- Qwen: 性价比潜力最大,但仍需验证。
- Gemini: 多模态与文件处理最有优势。
- OpenAI: Agent 工具和开发生态最完整。
四大模型快速对比
| 模型 | Arena 综合排名 | Arena 编程排名 | Context / 最大输出 | 标准 API 价格 |
|---|---|---|---|---|
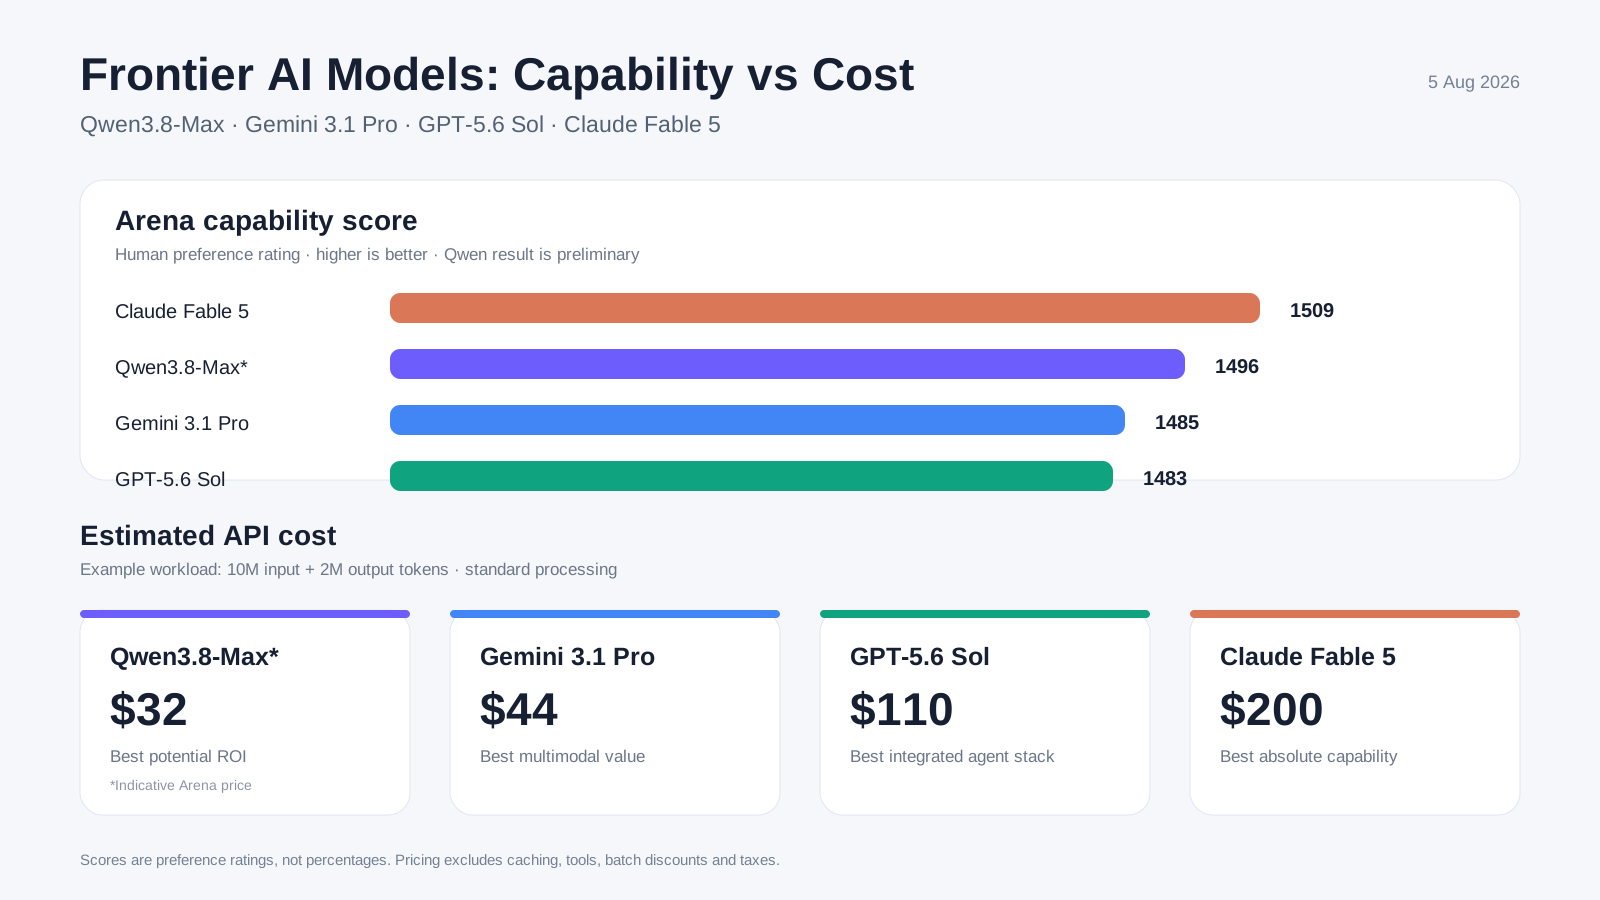
| Claude Fable 5 | #1,1509 ±6 | #1,1553 ±9 | 1M / 128K | 输入 $10 / 输出 $50 |
| Qwen3.8-Max | #5,1496 ±10* | #10,1530 ±19* | 1M / 未正式公布 | Arena 标示约 $2 / $6* |
| Gemini 3.1 Pro Preview | #12,1485 ±3 | #22,1521 ±5 | 1,048,576 / 65,536 | 输入 $2 / 输出 $12,限 200K 内 |
| GPT-5.6 Sol | #15,1483 ±6 | #13,1528 ±11 | 1,050,000 / 128,000 | 输入 $5 / 输出 $30 |
* Qwen3.8-Max 的排行榜成绩仍属于初步数据,投票数量较少,误差范围更大。Arena 标示的 $2 / $6 也不是 QwenCloud 已正式确认的标准 PAYG 报价。
1. Claude Fable 5:绝对能力最强
Claude Fable 5 在当前公开的人类偏好排行榜中同时占据综合与编程第一名。它的优势不是只会生成代码,而是更擅长处理大型代码库、长期任务、复杂迁移、多步骤分析和需要持续保持上下文的 Agent 工作。
对企业开发来说,它比较像一名经验丰富的 Senior Engineer:
- 能阅读大量既有代码和文档。
- 能在长任务中保持目标一致。
- 更适合复杂 Debug、架构调整和大型重构。
- 在需求不完整时,通常更能主动补足调查和验证步骤。
它的主要缺点是价格。输入每百万 Token 约 10 美元,输出约 50 美元,明显高于 Gemini、OpenAI 和 Qwen 的标示价格。
不过,模型成本不能只看每百万 Token。一个便宜模型如果需要多次重试、产生错误代码或需要人工重新检查,最终任务成本未必真的更低。
适合场景:
- 大型代码库调查
- 系统架构与复杂重构
- 长时间运行的 Coding Agent
- 高风险技术分析
- 需要较少人工修正的任务
2. Qwen3.8-Max:最具破坏力的性价比挑战者
Qwen3.8-Max 最值得注意的地方,是它已经不是“便宜但明显较弱”的模型。它在早期 Arena 数据中的综合和编程表现,已经接近 Claude、GPT 与 Gemini 的旗舰档位。
官方资料显示,它具备:
- 约 100 万 Token 上下文
- Thinking Mode
- Function Calling
- Structured Output
- Web Search
- Code Execution
如果后续数据稳定,而且真实 API 成本能够维持在较低水平,它可能成为非常有竞争力的企业模型。
但现在仍有几个不确定点:
- 排行榜样本量仍少,成绩需要更多投票验证。
- 目前缺少成熟的公开 Agent Arena 结果。
- QwenCloud 主要通过 Credits Token Plan 提供 Preview,难以直接换算成企业常用的每百万 Token 预算。
- Preview 模型可能被替换、调整或下线。
- 企业数据区域、保留期和 DPA 资料不如其他大型供应商成熟。
因此,我不建议企业马上把所有生产任务迁移到 Qwen。比较合理的方法是采用 Shadow Mode:让 Qwen 在后台处理相同任务,再与现有生产模型比较成功率、重试次数、延迟和真实成本。
适合场景:
- 成本敏感的代码生成
- 通用分析与内部工具
- 非敏感数据处理
- 模型评测与 Shadow Mode
- 需要长上下文但预算有限的工作
3. Gemini 3.1 Pro:多模态和文件处理最实用
Gemini 的最大优势不一定是纯文字排行榜,而是它对不同资料格式的原生支持。
它能够处理:
- 文字
- 图片
- 音频
- 视频
- URL Context
- Google Search Grounding
- Code Execution
- Function Calling
- Structured Output
这使 Gemini 特别适合 IDP、发票、报告、截图、录音与视频分析。
对于 ERP 或企业文件处理,很多任务并不是“回答一个文字问题”,而是读取二十页 PDF、识别表格、比较多张截图,再输出固定 JSON。Gemini 在这类工作上通常更直接,也更容易控制成本。
价格方面,200K Prompt 内大约是输入 $2、输出 $12。超过 200K 后价格会上升,但整体仍比 Claude 便宜。
适合场景:
- PDF 与 IDP
- 发票、采购单和报表识别
- 图片、视频和录音分析
- 长文件摘要
- 低成本多模态企业流程
4. GPT-5.6 Sol:完整 AI Agent 平台最强
GPT-5.6 Sol 未必在每一个公开排行榜中排名第一,但 OpenAI 的优势是整个平台组合。
Responses API 提供的能力包括:
- Web Search
- File Search
- Image Generation
- Code Interpreter
- Hosted Shell
- Apply Patch
- Computer Use
- MCP
- Tool Search
- Function Calling
- Structured Output
这意味着开发者不需要只靠模型本身,也可以使用完整的工具环境,让 Agent 搜索、执行、修改、验证和继续处理任务。
对 ERP AI Agent 来说,这一点很重要。真正可用的 Agent 不是只会聊天,而是需要:
- 理解用户要求。
- 读取系统资料。
- 调用正确工具。
- 执行任务。
- 验证结果。
- 记录审计信息。
OpenAI 的优势,就是这些功能已经形成比较完整的开发平台。
需要注意的是,GPT-5.6 Sol 在超长 Prompt 下会有长上下文加价。输入超过指定门槛时,整个请求可能采用更高价格计算。
适合场景:
- MCP 与工具型 Agent
- Coding Agent
- Computer Use
- 需要 Structured Output 的业务流程
- 多工具编排与复杂自动化
成本模拟
假设一个月使用:
- 输入 1,000 万 Token
- 输出 200 万 Token
- 不计算 Cache、Batch、工具费和税费
| 模型 | 估算成本 |
|---|---|
| Qwen3.8-Max | 约 $32* |
| Gemini 3.1 Pro,Prompt 不超过 200K | 约 $44 |
| GPT-5.6 Sol,Prompt 不超过长上下文加价门槛 | 约 $110 |
| Claude Fable 5 | 约 $200 |
| Gemini,Prompt 超过 200K | 约 $76 |
| GPT-5.6 Sol,进入长上下文加价 | 约 $190 |
* Qwen 成本使用 Arena 标示的 $2 / $6 作估算,并不是正式 QwenCloud PAYG 发票价格。
从这个模拟可以看到,最贵和最便宜可能相差超过六倍。但企业真正应该计算的是:
任务总成本 = API 成本 + 重试成本 + 人工检查 + 错误风险 + 延迟成本
Qwen3.8-Max 会不会造成资料泄漏?
Qwen3.8-Max 不会自动造成资料泄漏,但把资料发送到 QwenCloud,本质上仍然是把数据交给外部云端处理。
根据 QwenCloud 的安全说明,一般 API 输入与输出不会用于训练模型。普通请求通常只在内存中处理,但 Metadata,例如 Token 数量、时间和 Request ID,仍可能保留用于收费和服务运行。
这并不等于企业可以直接发送所有生产数据。
1. Responses 与 Conversation 功能可能保存内容
如果使用 previous_response_id、Conversations API 或服务器管理的对话历史,平台可能保存输入和输出内容。
不同官方页面对保留期限的说明并不完全一致,有的页面提到约七天,有的安全文件则提到三十天并可通过 store=false 关闭。
对企业用户来说,文档不一致本身就是需要书面确认的风险。
2. Token Plan 可能涉及跨境数据处理
Qwen3.8-Max Preview 的 Token Plan 区域虽然标示为 Singapore,但部署模式是 Global。官方条款说明,Prompt 与输出可能经过全球基础设施处理,因此可能构成跨境数据传输。
所以,人在新加坡并不代表数据一定只在新加坡处理。
3. 内容会经过自动安全审核
API 的输入和输出可能经过自动内容审核系统。即使这些检查不是人工阅读,也代表资料除了进入模型推理流程,还会经过其他平台组件。
4. 最常见泄漏点可能来自自己的系统
实际项目中,数据泄漏往往不是模型主动泄漏,而是发生在整条系统链路:
ERP → Chatbox → Backend → Log → Model API → MCP / Tool → Response
常见风险包括:
- Debug Log 记录完整 Prompt
- Browser localStorage 保存敏感资料
- Reverse Proxy 或 API Gateway 日志
- Sentry 等错误追踪平台
- MCP Tool 把数据传到第三方服务
- Prompt Injection 诱导 Agent 外传资料
- API Key 被提交到 GitHub
对 ERP 数据的建议
可以发送:
- 已脱敏的 Schema
- 虚构测试数据
- 不包含客户身份的错误信息
- 通用代码
- 已删除密码、Token 和个人资料的日志
- 聚合后的销售统计
不应直接发送:
- 客户完整资料
- NRIC、Passport、电话和 Email
- 银行账户或付款资料
- 员工薪资和个人资料
- 完整生产数据库 Dump
- Cookie、Session ID 和 API Key
- 未脱敏的 Invoice、Purchase Order 或财务报表
- 未经公司批准的完整私有源码
企业调用外部模型前,至少应该加入:
- 字段白名单
- PII Redaction
- Secret Scanning
- Prompt 与 Response 审计
- Tool Allowlist
- 租户与用户权限检查
store=false,若接口支持- 禁止默认启用 Web Search 或外部 MCP
适合 ERP AI Agent 的架构
企业不应该让一个最贵的旗舰模型处理所有任务。比较合理的是 Model Router。
第一层:普通任务
用于简单问答、分类、格式化和低风险结构化输出。
建议使用:
- GPT-5.6 Terra
- Gemini Flash 系列
- 经过验证的低成本模型
第二层:复杂推理
当任务涉及大型代码库、复杂 Debug、系统迁移或长时间 Agent 工作时,再升级到:
- Claude Fable 5
- GPT-5.6 Sol
第三层:多模态文件
当任务涉及 PDF、图片、录音、视频和 IDP 时,路由到:
- Gemini 3.1 Pro
第四层:Qwen Shadow Mode
让 Qwen3.8-Max 在后台处理相同任务,但不直接影响生产结果。
需要记录:
- 任务成功率
- 重试次数
- 延迟
- Token 或 Credit 消耗
- 输出正确性
- 数据合规性
达到内部标准后,再逐步增加真实流量。
最终选择建议
| 目标 | 建议模型 |
|---|---|
| 不计成本,追求最高质量 | Claude Fable 5 |
| 建设完整 ERP AI Agent 平台 | GPT-5.6 Sol |
| PDF、图片、录音和视频处理 | Gemini 3.1 Pro |
| 追求潜在最高性价比 | Qwen3.8-Max,但需要验证 |
| 企业生产最佳方案 | 多模型路由,而不是单一模型 |
最后的看法
大模型竞争已经不再只是“谁的 Benchmark 分数最高”。
企业真正需要比较的是:
- 能不能完成任务
- 会不会反复失败
- 能不能使用工具
- 能不能输出稳定 JSON
- 能不能控制权限和数据
- 出错后能不能追踪与恢复
- 每一个成功任务到底花多少钱
因此,我不会建议企业只选择一个模型然后全部押注。
更可靠的方向是:
用便宜模型处理大部分普通工作,用强模型处理困难任务,用多模态模型处理文件,再通过统一的安全网关、Model Router 和审计层管理所有调用。