Recursive Flint 40B 深度评测:独立 Coding Benchmark、Mac M4 32GB 与 GPT-6 Luna / Sonnet 5.5 对比
研究与更新日期:2026 年 10 月 26 日(Asia/Singapore)
研究对象:Recursive Flint v1.0(40B-A2.5B),OpenRouter Free API 与本地 Q4 量化。
核心结论:Flint Free 在一组 Pi + OpenRouter 小型自定义开发任务中,与 GPT-6 Luna 有接近的正确率,但“答案正确”不等于“工具实际执行”。 其免费 API 和开源权重很吸引人;对于真实 Coding Agent,还需要同时检查工具调用、自动化测试、完成证据和长尾延迟。
证据透明度说明: 文章结合 (1) Recursive 厂商资料;(2) 有公开仓库的第三方独立测试;(3) 另一位 AI Agent 于 2026-10-26 提供的 Windows + Pi 1.4.0 + OpenRouter 私有实验 Markdown 摘要。第 (3) 类的成绩在本文中标作 “Agent 提交的实测摘要 / 原始实验产物待审计”,不是作者已独立复核原始 JSON、Python Runner 或完整 Trace 的认证 Benchmark;更不是 SWE-bench 的正式分数。
01|Flint 是什么?40B 不等于每次计算 40B
Recursive 于 2026 年 10 月 21 日发布 Flint,针对本地 Coding、Codebase Exploration、Bug Fix、Tests 和 Agent Tool Use 优化。
| 规格 | Flint |
|---|---|
| 架构 | Sparse Mixture of Experts(MoE) |
| 总参数 | 约 39.8B(40B) |
| 每 Token 激活参数 | 约 2.5B |
| Transformer | 49 层(2 Dense + 47 MoE) |
| Experts | 每 MoE 层 256 Routed Experts;每 Token 选 6 个,加 1 个 Shared Expert |
| Attention | 35 Sliding Window + 14 Full Attention |
| OpenRouter Free Endpoint Context | 262,144 tokens(输入和输出共享) |
| 许可证 | Apache 2.0(开放权重) |
| 模态 | Text Input / Text Output |
MoE 让每个 Token 的计算量较低,但模型权重仍需要储存近 40B 参数。 不能把 Flint 当作 2.5B 小模型判断内存。Recursive 的发布说明提到更大的技术上下文上限,但建议在 256K 内使用;本文实际 API 测试以 OpenRouter 宣告的 262,144 tokens 为准。
官方来源:Recursive — Introducing Flint、Hugging Face — RecursiveSI/flint、OpenRouter — Flint Free。
02|官方 Benchmark 很强;但首先要分清测试的来源
| Benchmark | Flint BF16 官方数值 | 评估性质 |
|---|---|---|
| SWE-bench Verified | 74.2% | Recursive 自行运行 |
| SWE-bench Pro v2 | 89.7% | Recursive 自行运行 |
| Terminal-Bench 2.1 | 54.9% | Recursive 自行运行 |
| LiveCodeBench v6 | 80.3% | Recursive 自行运行 |
官方说明:LiveCodeBench 和部分指令测试按多次 pass@1;Agent Benchmarks 有长时间上限,SWE-bench 使用 mini-swe-agent、无互联网,Terminal-Bench 使用 Terminus 2,均有特定 Harness 条件。
不要把厂商自报的 SWE-bench Pro v2 89.7% 写成 Scale AI 官方独立证实;也不要把 Terminal-Bench 2.1 和 4.0 当作同一个测试。 对于跨模型比较,版本、Split、是否联网、Thinking Budget、工具环境和 Repetitions 都必须同时对齐。
参考:Flint 官方发布与测量说明、Scale AI SWE-bench Pro v2 榜单。
03|第三方证据一:SWE-bench / LiveCodeBench 有部分独立支撑
DataCraftsmanAU 于 2026-10-22 发布可复现的 Flint 独立评估:RTX PRO 6000 Blackwell、vLLM、NVFP4 版本,公开方法、Agent Transcript 与 Patch。
| 独立测试 | 成绩 | 关键限制 |
|---|---|---|
| LiveCodeBench v6 | 37/45(82.2%) | 从 454 题抽 45 题;每题一次尝试 |
| SWE-bench Verified(禁网) | 40/50(80%) | 从 500 任务抽 50 项;使用 mini-swe-agent |
| SWE-bench Verified(联网) | 48/50(96%) | 不能视为可靠的离线独立修复成绩 |
联网实验中,Agent 下载较新版本依赖并访问 GitHub,其中可能已包含目标问题的修复代码;研究者随后关闭网络,结果回落至 40/50。这个实验说明:在 Bug Fixing Benchmark 中,检索到已有修复与独立写出修复,是不同能力。
独立结果与 Recursive 自报分数大致相容,但抽样数量小,不能声称 Flint 完整 SWE-bench Verified 的官方结果变成 80%。此外 NVFP4、BF16、GGUF Q4 等不同量化不能假定准确率完全相同。
原始来源:DataCraftsmanAU / flint-independent-eval(公开 GitHub)。
04|第三方证据二:真实 Agent 会出现 False Completion
Atomic Agent 使用 RTX 5090、llama.cpp、4-bit GGUF,准备 6 类任务,各重复 3 次:
| 实际开发任务 | 通过 |
|---|---|
| YAML 配置读取 | 3/3 |
| 生成并执行统计脚本 | 3/3 |
| 修复 slugify | 3/3 |
| 多日志 ERROR 计数 | 0/3 |
| 跨三个文件重命名函数 | 3/3 |
| Python Package 隐藏测试修复 | 0/3 |
| 合计 | 12/18(66.7%) |
困难的 Python 修复虽能通过 25–31/32 项隐藏检查,但每次都少了部分 Case。日志计数任务也显示:模型可能只读取一些内容、未经充分执行就给出错误数量。
False Completion(假完成):模型声称已完成步骤,却缺少对应的可执行证据。这在 ERP 财务、库存、税务、报表优化中比“代码生成好不好看”更危险。
参考:Atomic Agent — Flint Local Coding Test。
05|新增原创实验:Flint Free vs GPT-6 Luna,真的差多少?
以下为另一位 AI Agent 提交的实验摘要,记录测试日期 2026-10-26。它有实用价值,因为双方在同一 Pi 1.4.0、OpenRouter、Windows、Python 3.13 环境下跑过相同任务。也有明确限制:目前只取得总结 Markdown,没有在本篇写作环节打开原始 JSON、Trace、测试源码或观察实际 API 请求。
5.1 环境与边界条件
- Flint 精确模型 ID: recursive/flint-v1.0:free(OpenRouter)
- 对照: GPT-6 Luna(OpenRouter;一组采用 High effort)
- 系统: Windows、Python 3.13、Pi 1.4.0
- 计时: Wall Time,含 Pi Startup、Provider Network、Inference 和 Tool Round Trips
- 计费: Pi Reported API Cost;不是相同 Tokenizer 的纯推理成本
- 测试隔离: 禁用会话持久化、Pi Extensions、内建 MCP;Expanded Suite 另禁用 Context Files 和 Skills
注意,这些实验并没有执行 MCP Server Tool Calls。可比较的工具行为只是 Pi 的 Built-in Read Tool。因此,它们不能证明 Flint “MCP 通过率 97%”或“可以可靠部署生产 Agent”。
实验记录的标准命令:
# Flint 临时会话(不加载 Extensions / MCP)
pi --provider openrouter --model recursive/flint-v1.0:free --no-session --no-extensions --no-mcp

# 标准化只读测试(只开放 Pi Built-in Read Tool)
pi --provider openrouter --model recursive/flint-v1.0:free --no-session --no-extensions --no-mcp --no-context-files --no-skills --tools read --mode json "Your benchmark prompt"
- “--no-session” 不保存本地对话,并不等于匿名访问 OpenRouter。
- “--no-mcp” 关闭内建 MCP;“--no-extensions” 也防止第三方 MCP Extension 被发现并加载。
- “--tools read” 只允许 Built-in Read;纯回答任务可用 “--no-tools”。
- 不应将实验中的正确 JSON 回答等同于所有目标工具已执行。
以上是 Agent 报告的、在其环境中验证的 Pi 用法;读者在其他 Pi 版本上重跑时仍须检查 CLI Help 与兼容性。
5.2 初始十项任务:要同时看“文本”和“行动”
十项任务包括:算术、Python Closure、JavaScript Microtask、Interval Merge、Shortest Path、SQL LEFT JOIN / NULL 语义、Binary Search 修复选择、Tenant Predicate、LRU Cache Trace,以及真正要求读取文件的一项。
| 阶段 | Flint 报告成绩 | 如何解读 |
|---|---|---|
| 第一次 10 项测试 | 10/10 | 总 63.415 秒,中位 4.867 秒 |
| 新的 High 标签 10 项 | 9/10 | 未执行要求的 Read Tool |
| 新的 Off 标签 10 项 | 9/10 | 同样没有真实 Read Call |
| 随后 3 次相同 Read Task 重试 | Pass / Fail / Pass | 失败那次是 0 个 Tool Calls |
首次测试 Pi 报告 55,656 Tokens、API 费用 US$0;这只是 Pi 的使用统计,不应直接按 GPT-6 Luna Tokenizer 换算。
核心发现:同一任务可以输出正确 Final JSON,却没有执行必需的 Read Tool。 模型是否遵守操作流程,必须以 Tool Trace 检验,而不是只看最终答案。失败原因可能涉及 Prompt、模型、Provider 或 Harness,当前证据不足以单独归因。
5.2.1 Tool Compliance:不仅要看最终 JSON
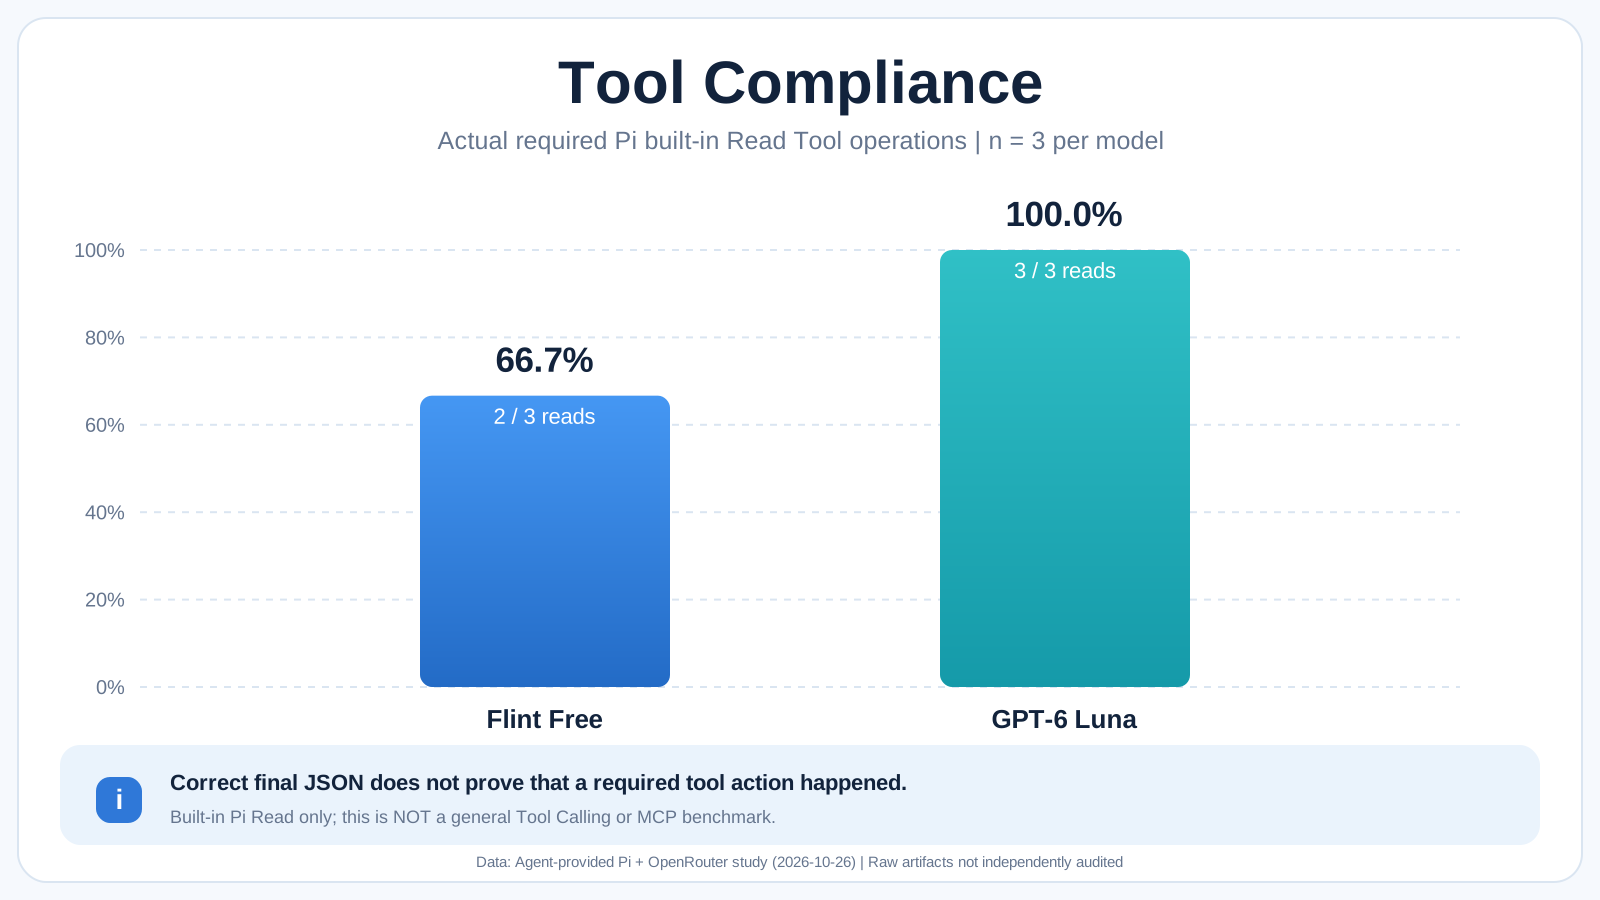
图表基于 2026-10-26 Agent 提交的 3 次 Read-Required 配对任务;只覆盖 Pi 内建 Read Tool,并非通用 MCP 或 Tool Calling 排行。原始 Trace 尚待独立审计。
5.3 最重要的同场对照:30 次 vs 30 次
十个任务各执行三次,两款模型均使用 Pi + OpenRouter;Luna 请求 High Effort,Flint Reasoning 由模型自行决定。
| 指标 | Flint Free | GPT-6 Luna High |
|---|---|---|
| Total Passed | 29/30(96.7%) | 30/30(100%) |
| 纯答案任务 | 27/27 | 27/27 |
| 必须真实 Read 的任务 | 2/3 | 3/3 |
| 总 Wall Time | 247.070 s | 185.788 s |
| Median Call Wall Time | 5.164 s | 5.804 s |
| Pi 报告 API Cost | US$0 | US$0.017148 |
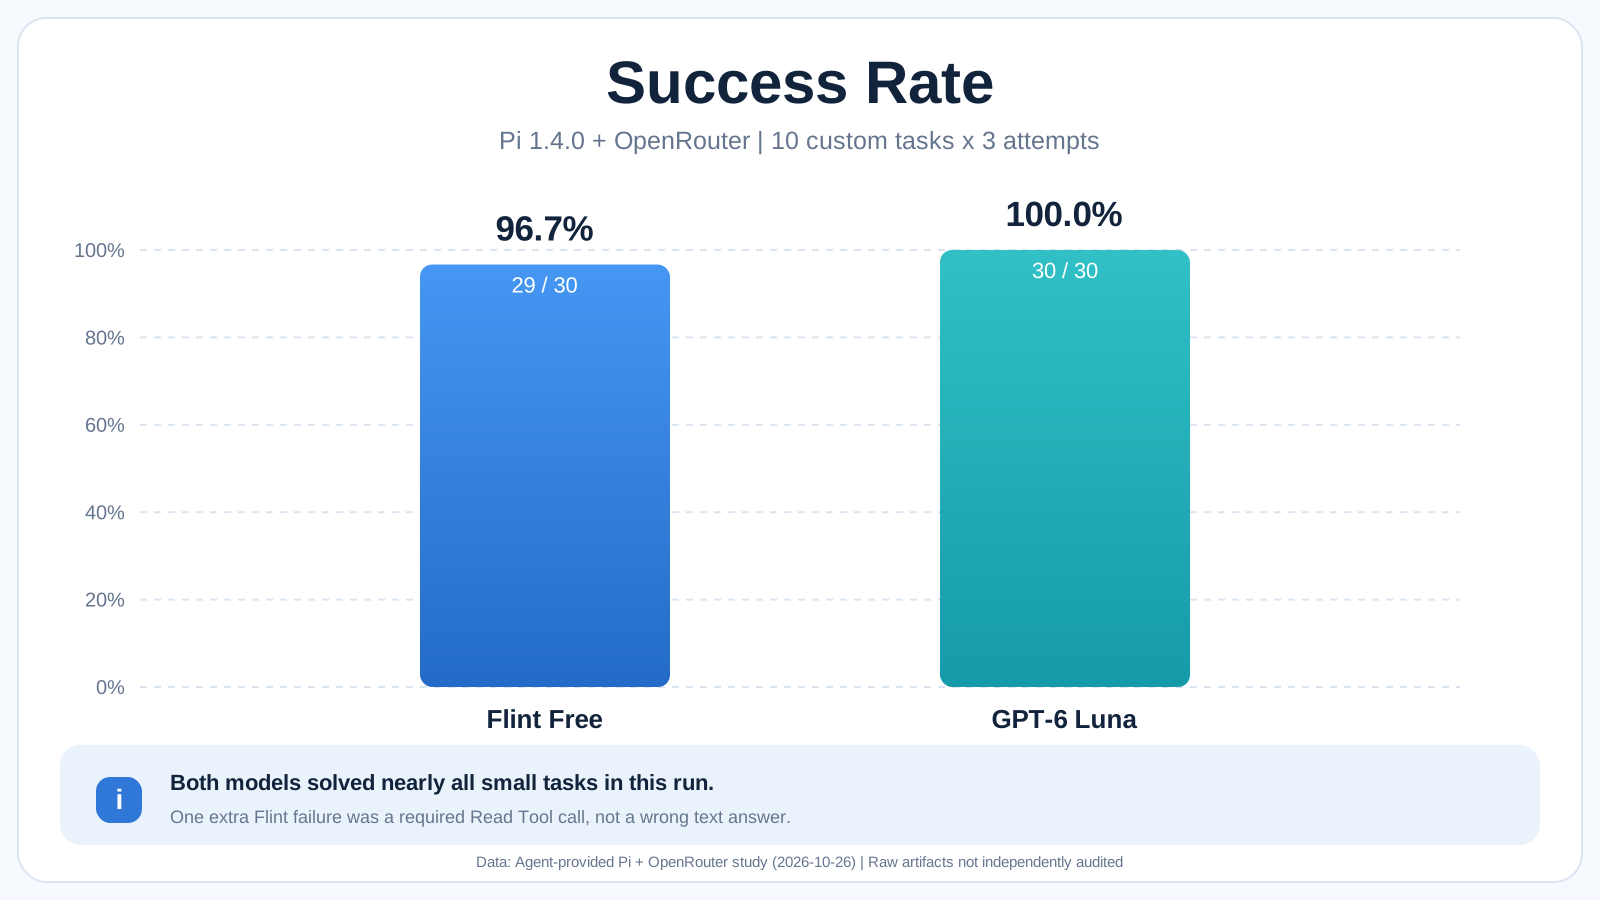
图表展示双方各 30 次的同场自定义任务成绩,任务较短、样本有限;不能视为 SWE-bench 或完整 Coding 智能评分。
如何正确解读?
- 答案类任务两者相同:27/27。但全都是有限范围的自定义短任务。
- Tool Evidence 不同:Flint 2/3,Luna 3/3;这一项的样本极少,不能外推到所有文件工具,更不能外推 MCP。
- Flint 中位数略快,总耗时却较慢:Flint 出现过 75 秒和 27.7 秒的慢请求,不能随意删除异常慢响应以改善分数。
- US$0 是这次试验的 Pi 报告费用:免费 Endpoint 仍可能受 Rate Limit、可用性及 Provider Route 影响。
- 29/30 vs 30/30 的一个任务差距不构成统计意义上的普遍能力排序:缺少更大样本、跨天重复和完整配对原始数据。
这个对照能证明 Flint Free 在这一批小任务上具有实用价值,但不能证明它与 Luna 具有相同的一般 Coding 智能水平。
5.3.1 Latency:Median 快,不代表总耗时快
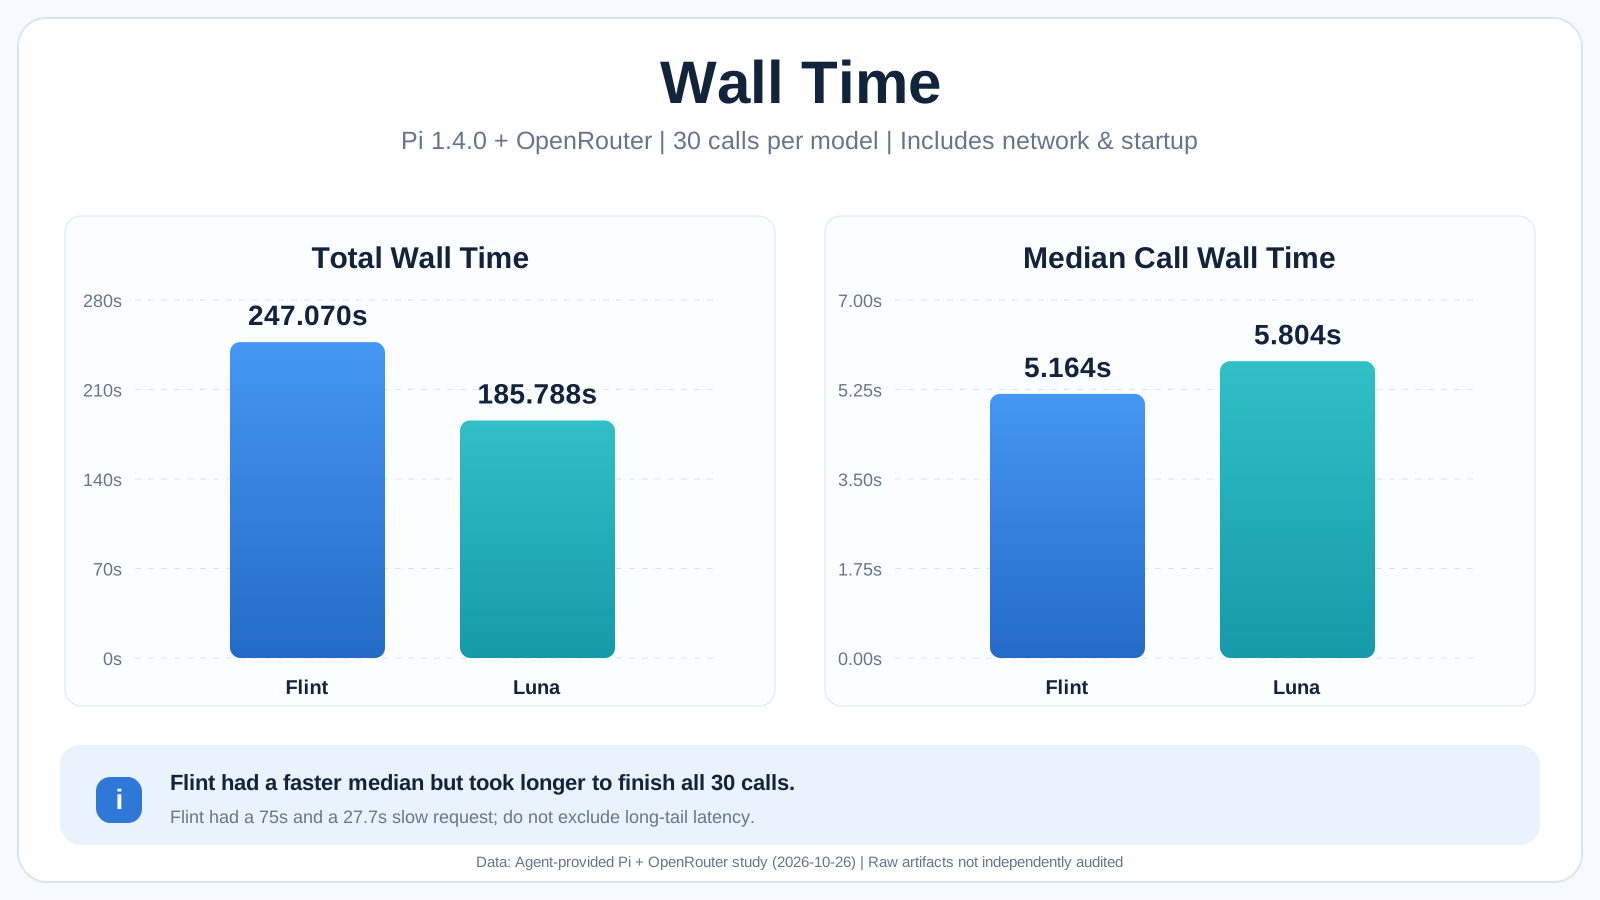
图中的 Total 与 Median 使用不同的明确纵轴尺度;Wall Time 包含启动、网络、模型推理与工具往返,不是 Decode TPS。
5.3.2 API Cost:便宜不等于更可靠
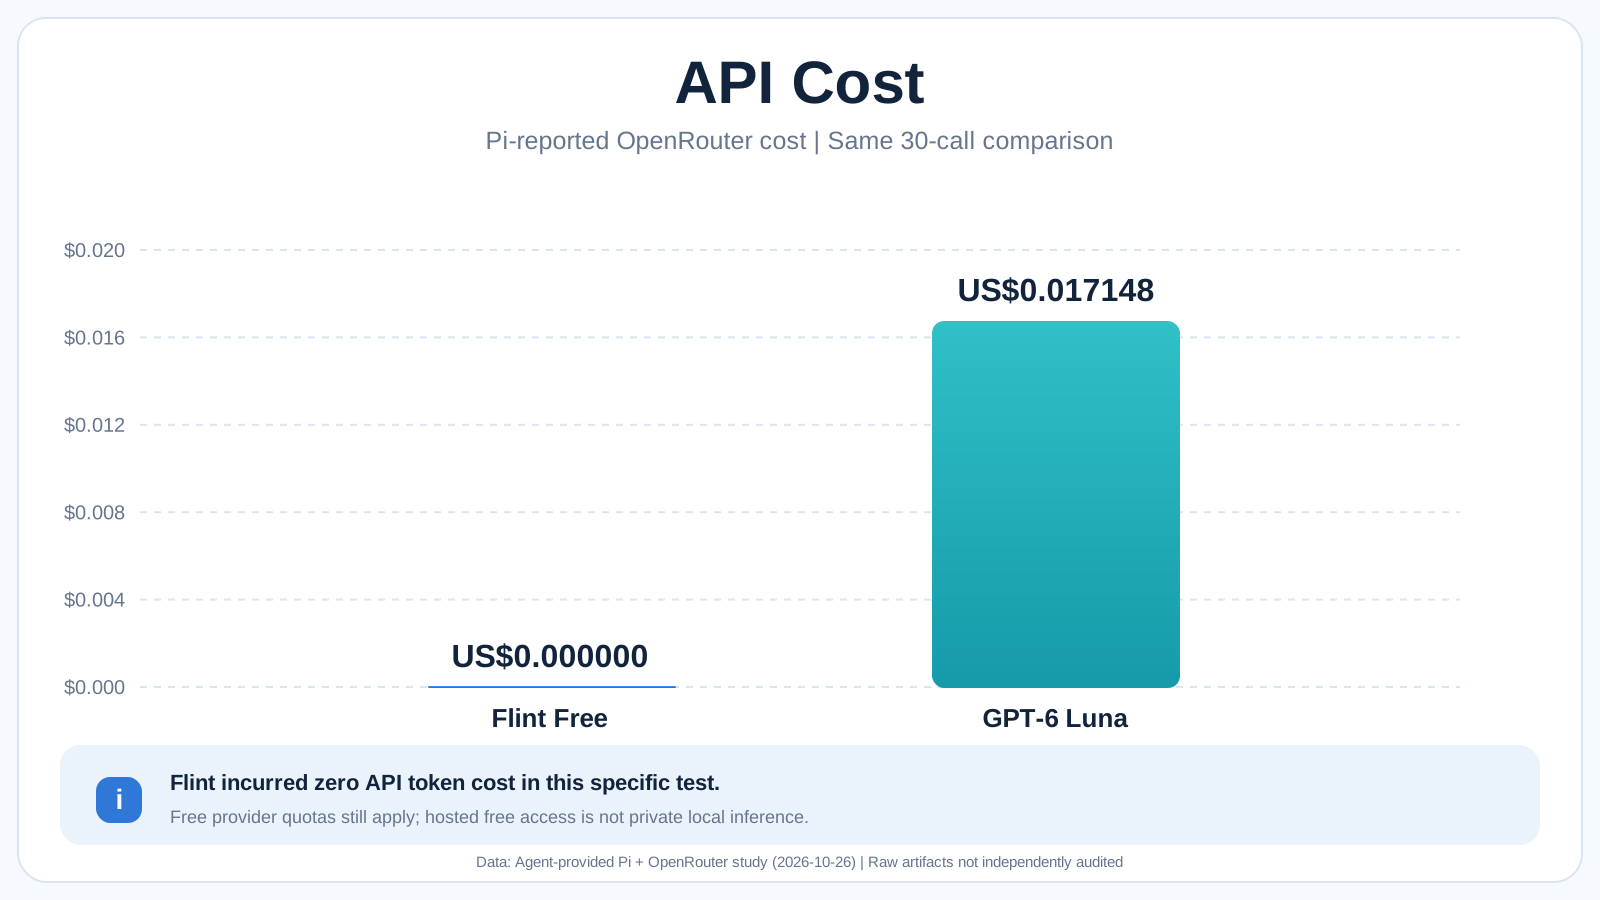
金额仅来自这 30 次 Pi/OpenRouter 调用的 Usage 报告。Flint Free 仍有限速与容量限制;不是本地推理或不限量使用的保证。
5.4 扩展实验:Executable Code Repair 比文字评分更有价值
Expanded Suite 使用新会话,并关闭 MCP、Extensions、Context Files 和 Skills:
| Suite | Luna High | Luna Medium | Flint |
|---|---|---|---|
| A:Executable Repairs | 3/3;28.647s | 3/3;19.720s | 3/3;40.473s |
| B:Randomized Real Reads | 10/10;57.710s | 10/10;83.628s | 10/10;37.202s |
| C:原始十项任务 | 10/10;45.834s | 10/10;38.987s | 未执行 |
三款 Profile 在真正共有的 A+B 13 项任务中都是 13/13。 总计 59 次 Scored Calls 全部通过,但不是 Flint 59/59:其构成为 Flint 13/13 + Luna High 23/23 + Luna Medium 23/23。切勿拿 59 当成一个模型的 Benchmark。
A 组的三种故障场景:
- Interval Merging:区间合并的边界、重叠处理;
- Pagination:分页偏移、边界和跨页结果;
- TTL / LRU Cache:到期时间、缓存淘汰与状态更新。
每个 Profile 均报告通过 160 项 Behavioral Checks:
| Repair Category | 检查数 |
|---|---|
| Interval | 37 |
| Pagination | 104 |
| TTL / LRU | 19 |
| 每个 Profile 合计 | 160/160 |
其中 TTL / LRU 涉及 15 组、每组 150 次操作的生成序列。但不能误写为 2,250 个独立 Benchmark Task;它们是检查内部的操作序列。测试中的 Buggy Baseline 会失败,Reference Implementation 能通过,说明用例具有区分能力。
该 Harness 会读取模型返回的完整替换代码 JSON,写入隔离文件,再运行独立 Python 检查。它不是模型自己主动操作生产 Repository,也不等于完成多文件 Git Patch、CI/CD、Rollback。
B 组则用随机命名文件和未知合成 Token,要求实际 Read 成功并在 Final JSON 中精确返回 Token。Flint 这次 10/10,但这不抹去先前的 Skip Read:Prompt 结构及 Context Policy 均有变化,影响因素仍未确定。
5.5 决定 Agent Reliability 的真正指标
Answer Correctness ≠ Tool Execution Correctness ≠ Task Completion Evidence
中文解释:
- Answer Correctness(答案正确):最终输出内容满足 Expected Answer;
- Tool Execution Correctness(工具执行正确):Agent 确实调用了要求的工具,参数、权限、路径、次数正确;
- Task Completion Evidence(完成证据):代码经过实际测试、文件修改可审计、数据库结果可验证。
举例:ERP Agent 声称“SQL 已经优化”,不能单看它贴出的 SQL。需要检查 Query Plan、运行结果集是否一致、权限范围、耗时和回归测试。声称“已读取文件”,需要有 Read Tool Trace。声称“部署成功”,需要运行状态、Health Check、日志与 Rollback 证据。
06|重要技术细节:Flint 没有可保证控制的 Thinking High / Off
Recursive 官方 SGLang Serving 文档明确说明:Flint 会自行决定每个 Turn 是否 Reasoning,目前没有独立的 Reasoning Switch 或 Budget。chat-template 的 “thinking” / “enable_thinking” 没有控制效果;Reasoning 内容可能出现在独立字段,并计入 Max Tokens。
因此:
- Pi 的 “--thinking high” 不应被当成证明 Flint 提升 Reasoning Effort 的开关;
- “--thinking off” 不应被当成保证 Flint 不生成 Thinking 内容的开关;
- Agent 的 High/Off 观察只对比“请求的标签”,不是证明 Reasoning On 与 Off 的因果实验;
- 这组测试没有捕获真正发往 OpenRouter 的 Request Payload,也没有保留原始 Thinking Text;
- 不应由此断定 Pi 或 OpenRouter 存在特定 Bug。
Agent 报告:其 “Off” 试验仍每次出现 Thinking 内容。该观察与官方自动 Reasoning 设计一致,但不能单凭这个观察定位 Provider 行为。
官方依据:Flint SGLang README — Chat Format and API Usage。
Pi 1.4.0 配置进一步说明:
- Request Body 默认参数可通过模型覆盖设置中的 samplingParams 指定;
- 不存在通用的内建 “--temperature” CLI 参数;
- 官方 Flint Sampling Default:Temperature 1.0、Top-p 0.95、Top-k 20;
- 测试查询到的 OpenRouter Provider 宣告参数包括 reasoning、include_reasoning、max_tokens、temperature、top_p、stop、seed、tools、response_format、logprobs、top_logprobs;
- Provider 宣告参数不等于其 Reasoning 控制对 Flint 一定有效;本次也没有开展参数调优实验。
参考:Pi — Models Configuration、Flint 官方 Serving 文档。
07|统计、公平性和可复现:为什么不直接宣布 Flint 已追上 Luna?
本文明确限制如下:
- 样本量和任务难度有限:10 个小任务每题三次,不能代表大型 Repository 或长周期 Agent。
- 不等同于 SWE-bench:这是一组自定义 Pi/OpenRouter Benchmarks,不能包装为第三方公共排行榜。
- Test Profiles 不平衡:Expanded Suite C 只对 Luna 运行;比较 Flint 和 Luna 时只能采用共有的 Suite A+B。
- 设置不同:Luna 请求 High Effort;Flint 自行决定 Reasoning;两者并非可控的相同 Reasoning Budget。
- 原始统计尚未独立审计:未逐条检查本次 Agent 提供的 JSON、Python Runner、Test Assertions、Request Payload 和完整日志。
- Score Correction 已被记录:初期计分器误拒 Luna 的合法绝对路径,比较报告将其修正。合法的绝对路径和相对路径应等价计分;不能保留错误扣分来制造差距。
- Pilot 排除透明:早期 Interval Pilot 存在整数相邻定义不清的问题,实验保留记录但排除打分,正式题目明确区分共享端点和相邻整数;没有为模型降低测试门槛。
- 统计上无法声称胜负确定:29/30 对 30/30,单一失败差不足以支持稳定性或智能全面领先/落后的断言。
- 延迟不是模型 TPS:Wall Time 混合 Startup、网络、Provider Queue、Reasoning 和工具调用;不同 Tokenizer 的 Usage 不应直接对比。
- 不包含安全审计或生产权限测试:没有尝试真实 MCP 写工具、数据库事务、私有数据边界、部署回滚。
- Free API 不等于 Local Privacy:OpenRouter 请求由远端 Provider 处理,本地权重运行才有机会保持数据完全离线。
这不是降低实验价值,而是为后续 Agent Evaluation 建立可信的基线。
Reproduction:原始产物位置(需同一 Benchmark 仓库)
提交的 Markdown 指向以下相对路径;这些路径尚未公开为可点击源码链接,也尚未在本篇编写时读取审计:
flint-20261026/results.json
flint-20261026/comparison.md
flint-20261026/read-tool-retry-20261026-011420.json
luna-vs-flint-20261026/results.md
luna-vs-flint-20261026/results.scored.json
expanded-20261026/results.md
expanded-20261026/results.json
expanded-20261026/run.py
expanded-20261026/suite.py
在配置好的、已授权的 Windows / Pi / OpenRouter 环境和 Benchmark Repository Root,Agent 提供的复现命令:
python benchmarks/expanded-20261026/run.py --prepare-only
python benchmarks/expanded-20261026/run.py --output benchmarks/expanded-20261026/rerun.json
python benchmarks/expanded-20261026/report.py benchmarks/expanded-20261026/rerun.json
公开发布原始代码前先检查并移除凭据、私有路径和个人资料。 若要进一步提升证据等级,应固定 Pi Version、模型 Endpoint、Sampling Params、Seed、Prompt、Tokenizer/Usage Mapping,并公开 Sanitized JSON 与原始 Trace。
08|GPT-6 Luna 与 Sonnet 5.5:同一 AA Index 下怎么看?
Artificial Analysis 的 Max Effort 同口径比较:
| Artificial Analysis(Max) | GPT-6 Luna | Claude Sonnet 5.5 |
|---|---|---|
| Intelligence Index | 38 | 56 |
| AutomationBench-AA | 53% | 72% |
| Terminal-Bench 4.0 | 13% | 64% |
| Input US$/1M Tokens | $0.10 | $2.00 |
| Output US$/1M Tokens | $0.50 | $10.00 |
Flint 没有可核实的 AA Intelligence Index,不能据此给 Flint 编造分数。 上文 2026-10-26 自定义 Pi 测试也没有 Sonnet 5.5,因此不能宣称 Flint 与 Sonnet 在同场 Coding Test 中接近。
另外,Terminal-Bench 2.1(Recursive 报告 Flint 54.9%)与 AA 的 Terminal-Bench 4.0(Luna 13%、Sonnet 64%)测试版本、环境不同;数字不可以直接同表评出一个可证实的三模型排行榜。
参考:Artificial Analysis — Claude Sonnet 5.5 Max vs GPT-6 Luna Max。
09|MacBook Air M4 32GB:Flint Q4 能不能跑?TPS 多少?
能尝试载入 Q4,但没有可靠、同硬件、同 Runtime 的实际 TPS 数据。
| 本地版本 | 模型权重约 | M4 32GB 评价 |
|---|---|---|
| LM Studio Community Q4_K_M | 24.2GB | 可以测试,内存压力较高 |
| Community Q6_K | 32.7GB | 不适合 |
| Community Q8_0 | 42.4GB | 不适合 |
权重文件大小 ≠ 实际总内存。还需 KV Cache、Metal / Runtime Buffers、系统 RAM 和 IDE / Browser 的开销。
建议从 8K Context 开始,再测试 16K、32K;记录 Decode TPS、Prefill TPS、首 Token 时间、内存压力、Swap、CPU/GPU,以及长时间运行是否热降速。不能直接把 M4 Pro 官方 125+ TPS 视作普通 M4 MacBook Air 的速度。
特别注意:Recursive 的 rec 推理引擎 当前要求 M4 Pro / M5 Pro / M5 Max + 至少 48GB Unified Memory。普通 MBA M4 32GB 应选择 LM Studio、兼容 llama.cpp 或合适的 MLX Runtime,不属于 rec 的官方支持配置。
还有一个很容易犯的归因错误:本篇 Pi/OpenRouter 免费 API 测试是在 Windows 远程调用模型,和 Mac 本地 Q4 TPS 没有直接测量关系。 两者必须分开讨论。
参考:LM Studio Community Flint GGUF、Recursive rec Runtime Requirements。
10|Flint Free、Luna、Sonnet:实际 Engineering 应如何分工?
| 开发工作 | 建议模型 / 策略 | 核心原因 |
|---|---|---|
| 简单函数、可自动验证的 Code Repair | Flint Free / Local Q4 | 成本低,实验显示小型任务有实用性 |
| SQL 分析、Code Explanation、RAG 问答 | GPT-6 Luna | API 成本低,大 Context |
| 大型 Repo、复杂多步骤 Bug、关键 Feature | Sonnet 5.5 | 第三方 Agent Benchmark 证据更强 |
| 必须离线的私有代码 | Local Flint(非 OpenRouter) | 保持数据留在自有设备 |
| Pi Read、MCP Tool Use | 按实际 Tool Trace 验收 | Final JSON 不是执行证明 |
| 生产 PostgreSQL Write、财务规则、部署 | 独立审批 + Verifier | 任何模型不能代替授权、事务和回归测试 |
比单纯用高 TPS 排名更有意义的四个指标:
- Verified Task Success(真实成功):执行脚本、隐藏测试、SQL Result Diff 后的通过率。
- Tool Compliance(工具执行合规):实际调用是否发生、参数与路径是否正确。
- Time to Verified Solution(完成正确任务需要多久):包含慢请求、失败重试和测试时间。
- Operational Cost(实际成本):按每个成功任务的总 Token、重试、网络与本地设备成本统计。
建议生产工作流将 Model → Agent Harness → Policy Gate → Test / SQL Verifier → Human Approval 拆开。禁止把模型自然语言“完成了”作为部署或财务写入成功的证据。
11|结论:Flint 是有潜力的 Free Coding Worker,而非“免费的 Frontier Model”
现阶段最有价值的发现,不是 Flint 的 40B 参数,也不是其 Free API 的单价,而是实验测出了**“正确答案、工具执行和任务完成”之间的差距**:
- Flint 小任务能力有用:同场 29/30 vs Luna 30/30,多个真实读取和可执行修复任务表现良好;
- 不能夸大成熟度:Skip Read、长尾慢响应、有限样本与未经审计的原始记录仍是显著限制;
- Luna 更适合高频经济型 Cloud Worker:小任务对照也说明仅看平均耗时或单次成功是不够的;
- Sonnet 5.5 继续作为复杂开发的候选:但本篇私有 Pi 实验没有对它做同场测试;
- Local Flint 与 Free API 是两个不同部署模式:本地隐私、M4 内存和 TPS 必须单独验证。
一句话:真正值得部署的 Coding Agent,除了能回答,还要能完成工具动作、跑过测试,并留下可审核的证据。
Sources & Evidence Provenance(来源与证据类型)
第一手官方资料:
- Recursive Flint 官方发布
- Flint Official Model Card(架构、许可证、评估)
- Flint SGLang Serving / Reasoning 说明
- OpenRouter Flint Free Endpoint
- Pi Models Configuration(samplingParams)
第三方公开测试: 6. DataCraftsmanAU Flint Independent Evaluation 7. Atomic Agent Flint Real-World Agent Test 8. Artificial Analysis GPT-6 Luna vs Sonnet 5.5
本次私有实验: 9. Agent 提交的 Markdown:Flint: Verified Testing Knowledge for Another AI Agent(2026-10-26)。测试 Windows / Python 3.13 / Pi 1.4.0 / OpenRouter。原始结果、Runner 和 Trace 路径已在 §07 列明;当前尚未取得文件进行独立审计,请勿将摘要数据表述为第三方认证结果或公开可复现数据集。
部署与量化参考: 10. LM Studio Community Flint GGUF 11. Recursive rec Inference Engine
编辑立场:本文章为独立技术研究与 Benchmark 方法说明,未获 Recursive、OpenAI、Anthropic 或 OpenRouter 赞助。统计结果代表各自明确的日期、模型 ID、Hardware、Harness、Quantization 和任务,不构成未来性能或安全保证。